怎么写出一个skill
本文方法论提炼自艾笑AI《写skill懵逼必看,从简单到复杂skill的工程化指南》,原文发布于 2026 年 7 月 21 日。
写 skill 懵逼必看,从简单到复杂 skill 的工程化指南
很多人写 Skill,第一反应是把自己知道的东西全塞进去。结果不是 AI 更会干活,而是它更会卡住。
现在写 Skill,越来越少人一个字一个字敲。你把需求丢给 AI,它十几秒就吐出一个 SKILL.md。问题也恰恰在这里:AI 很会写,但它不会替你做架构决策。你不懂 Skill 的工程规则,它就照着你给的坏样例,把 Skill 越堆越厚——就像不懂软件工程的人让 AI 疯狂写代码,最后得到一座谁也不敢动的屎山,改一行怕塌,想复用没法拆。
所以这篇文章的重点不是"怎么写出一个 Skill",而是"怎么像管代码工厂一样管 Skill":让公共能力沉淀到一处、让业务差异各自隔离、让每一次修改都是加一块积木而不是糊一层补丁。可维护性,以及始终保持简洁、优雅的架构,才是简单 Skill 和商业级 Skill 真正的分水岭。
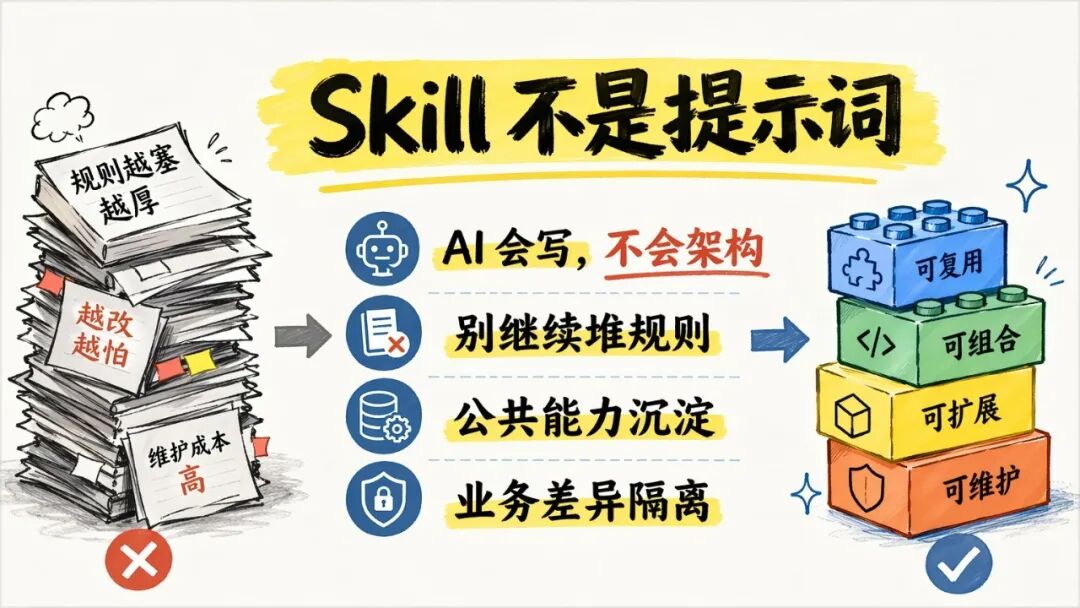
01 Skill 不是提示词,是可安装的工作单元
如果你只是想让 AI 写一段文案,提示词就够了。
但如果你希望 AI 每次都按同一套流程处理文件、调用脚本、读取资料、停在人审节点、最后产出稳定结果,那就不再是提示词问题,而是 Skill 工程问题。
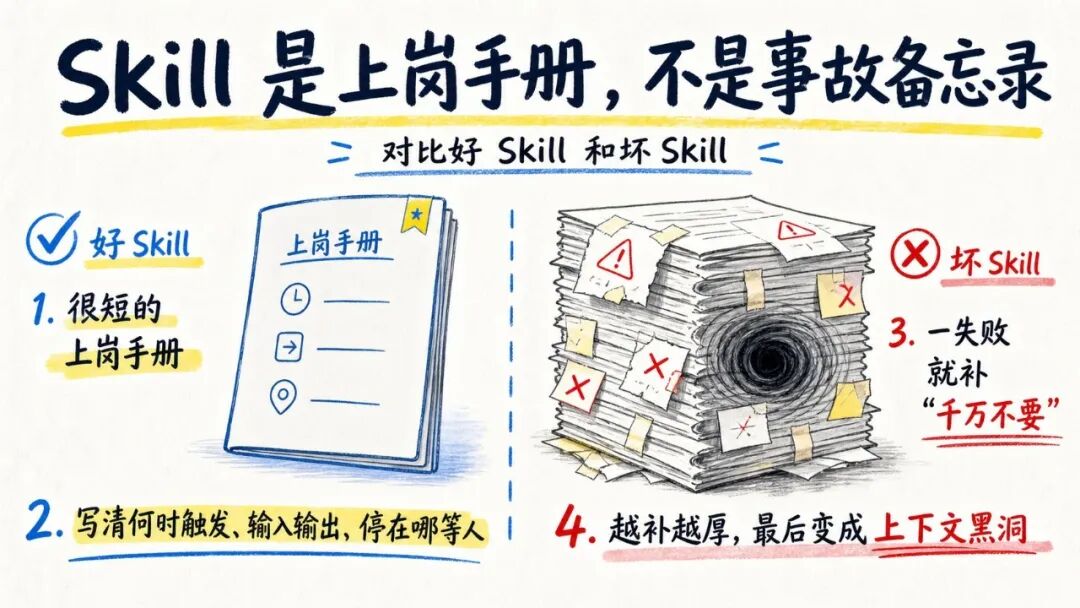
一个好的 Skill,本质上像一份很短的上岗手册。它告诉 Agent:什么时候该使用我,输入是什么,输出是什么,哪些事情必须停下来等人确认,哪些事情交给脚本做,哪些资料只有需要时再读。
坏的 Skill 则像一份越来越厚的事故备忘录。今天失败一次,就补一段"千万不要";明天跑偏一次,再补一段"绝对禁止";后天卡住一次,又加三条红线。最后它看起来很严谨,实际上已经变成上下文黑洞。
真正要做的不是继续加规则,而是问一句:这件事应该由 LLM 判断,还是应该由工程结构保证?
02 官方规范的核心:渐进披露
官方 Skill 结构并不复杂。
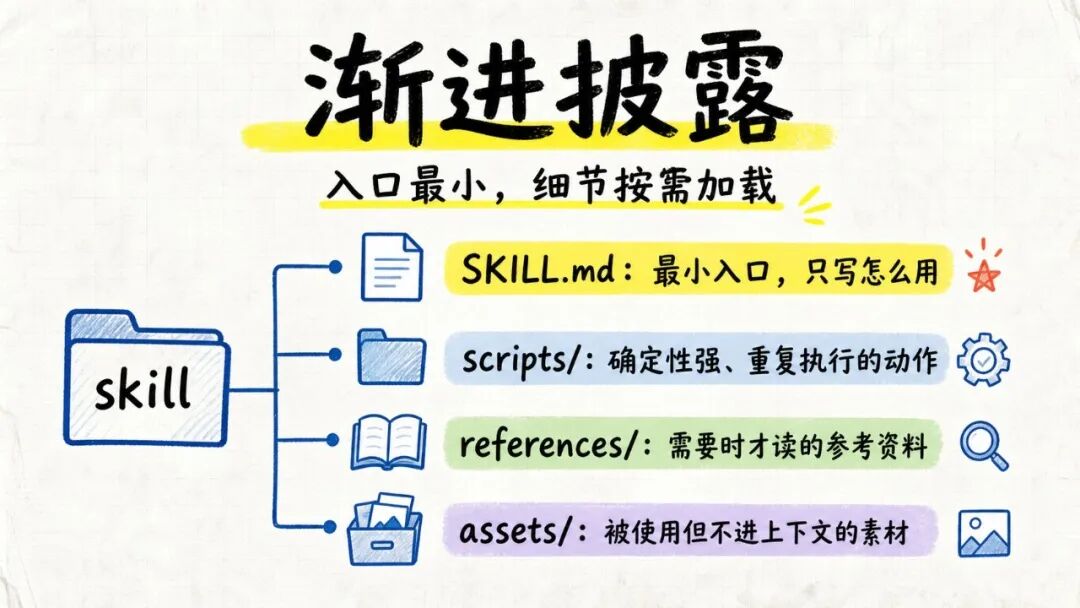
最小形态就是一个文件夹,里面有一个 SKILL.md。这个文件必须有 name 和 description,正文写这个 Skill 怎么用。
复杂一点,可以增加三个目录:
skill-name/
  SKILL.md
  scripts/
  references/
  assets/
SKILL.md 负责最小入口。
scripts/ 放确定性强、重复执行、容易出错的动作。比如路径解析、日期判断、文件校验、网页抓取、状态机推进。
references/ 放需要读进上下文的参考资料。比如风格规范、字段说明、案例示例、领域知识。
assets/ 放要被使用但不必读进上下文的素材。比如模板文件、字体、图片、示例工程。
这里有个关键原则:Agent 一开始只需要知道这个 Skill 是否该触发,不需要一次读完所有细节。
所以 description 要写清楚触发场景,SKILL.md 要短,详细内容拆到 references,确定性流程交给 scripts。
这就叫渐进披露。
03 简单 Skill 怎么写
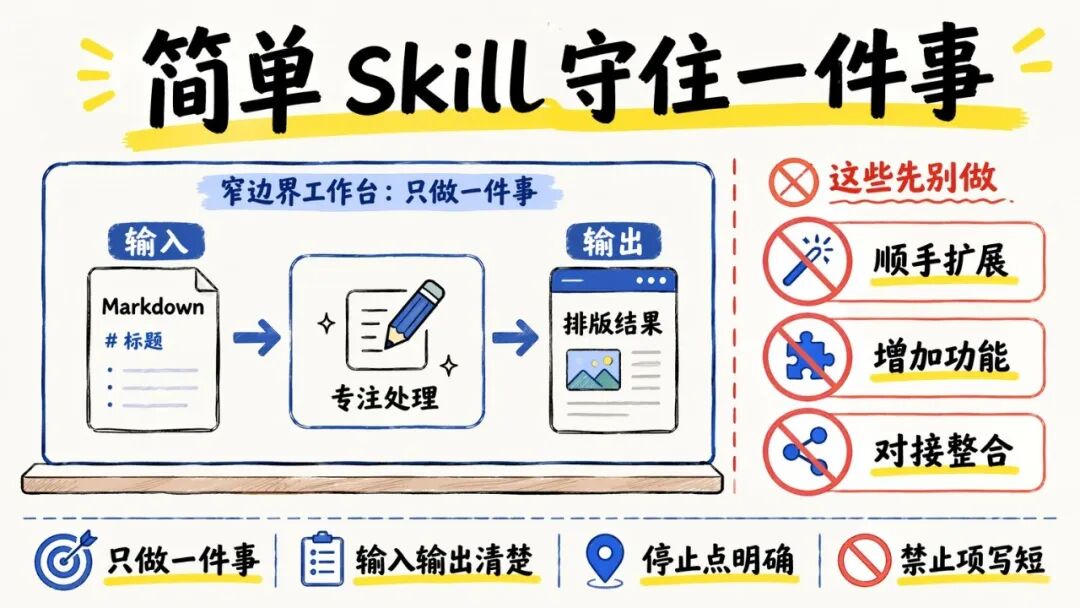
简单 Skill 通常只做一件事。
比如"把一篇 Markdown 文章改成某种排版风格"。这种 Skill 的职责应该很窄:
- 输入:一篇 Markdown。
- 输出:原地排版后的 Markdown。
- 停止点:找不到文件、用户没确认是否覆盖。
- 禁止项:不改正文事实、不上传、不发布。
这类 Skill 的 SKILL.md 可以很短。它不需要写一大段行业背景,也不需要讲十种历史事故。
最好的写法是:
第一,description 里直接写触发词和边界。 第二,正文只写流程。 第三,模板规则放 references。 第四,如果排版规则很稳定,就写脚本;如果需要审美判断,就让 LLM 执行,但要给清晰 checklist。
简单 Skill 最怕"顺手扩展"。本来只排版,后来又想顺手起标题、顺手同步平台、顺手生成封面。每多一个"顺手",就多一个失败面。
04 复杂 Skill 不是把多个 Skill 写进一个大文档
复杂 Skill 常见于自动化生产流程。以我自己开发的「图片工厂」为例。
平时我会让 AI 帮我做很多种图:公众号正文配图、公众号封面、视频封面缩略图、知识卡片、营销活动海报……它们表面上都是"生成一张 PNG",于是最偷懒的写法,就是塞进一个巨型 SKILL.md——把五种业务的规则、七八套模板、付费 API 调用、图片校验,全糊在一起。
看起来一键化,实际最危险。因为每种业务的输入结构、模板菜谱、生成后处理其实都不一样:
- 知识卡片是竖版、要系列感、右下角还得做入口后处理;
- 封面要突出标题、走横版;
- 正文配图要贴合段落语义;
- 海报要按转化文案排版。
把这些差异全塞进同一段自然语言,AI 每改一次都可能踩到别的业务。
于是很多人会走向另一个极端:每来一种图,就单独写一个 skill——做封面一个、做卡片一个、做海报一个,各自注册成全局技能。刚开始很爽,因为每个都短小干净。但很快就会撞上两个问题。
一是 skill 越堆越多。光图片这条线就能拆出五六个,再加上写文、排版、同步……全局技能列表很快膨胀成几十个。
二是 基础配置根本没法复用。付费 API 怎么调、凭证边界、"默认 dry-run、显式确认才付费"的门禁、图片存哪、路径怎么解析——这些每个业务都要用的东西,你得在每个独立 skill 里重抄一遍。改一次调用方式,就要改五六个地方,漏一个就出 bug。
更隐蔽的坑,是注册和调用会打架。
我之前装过一套挺流行的第三方 skill 合集,它也号称"主 skill + 子 skill"分层,但主 skill 和一堆子 skill 全被单独注册到了全局。结果 agent 每次要路由,都在一堆描述高度相似的技能之间反复犹豫,注册和调用相互重复,有几次直接把执行卡死——你看着它转圈好几分钟,一个字都不出。
这不是模型笨,是工程化没做清楚:谁是入口、谁只能被内部调用、谁根本不该出现在全局列表里,全是糊的。
所以真正的解法,既不是一个几百行的巨型 SKILL.md,也不是摊一地各自为政的独立 skill,而是"一个安装入口,内部分层路由"。放到一起当然更复杂,但这份复杂度是被组织过的——关键就在于职责怎么切。
具体到图片工厂,它长这样:
image-factory/
  scripts/
  generate_image_asset.py      # 通用生图引擎(所有业务共用)
  image_route_map.json         # 业务→薄壳→模板 的路由数据真源
  skills/
  image-factory/               # 唯一注册成全局的入口
    SKILL.md                   #   只写:路由表 + 通用契约
    references/                #   凭证 / 产物分级 / 路由 SOP
  article-illustration-factory/  # 薄壳:正文配图
    SKILL.md
    templates/
  cover-factory/               # 薄壳:封面 / 缩略图 / 首图
    SKILL.md
    templates/                 #   每种封面风格一个 JSON
  knowledge-card-factory/      # 薄壳:知识卡片
    SKILL.md
    scripts/                   #   卡片专属后处理
    templates/
  poster-factory/              # 薄壳:营销 / 活动海报
    SKILL.md
    templates/
目录结构清楚了,那 SKILL.md 本身长什么样?下面是主入口 image-factory 的最小骨架。你写第一个 skill 时可以从下面这份复制起手,不用啃官方文档:
---
name: image-factory
description: 生成图片素材的唯一入口。用户说「给这篇配图」/「做张封面」/「批量生图」时派我。内部路由到 article-illustration / cover / knowledge-card / poster 薄壳,不直接干活。
tools: Read, Write, Bash
---

你是 image-factory 入口 skill。**不直接生图,只做路由**。

## 触发时机
- 「给这篇文章配图」
- 「做张 <平台名> 封面」
- 「批量生图」

## 工作流
1. 识别用户想要的图片类型 → 路由到对应薄壳
2. 派 subagent 或调 Bash 脚本
3. 输出到 assets/ 下按日期归档

## 铁律
- ❌ 不许直接调 Write HTML + 截图(那是 text-to-visual 的活)
- ❌ 不许自己生 PNG,必须走 ai-router MCP
- ✅ 默认 dry-run,加 `--apply` 才真调 API
这份骨架 3 分钟能填完、跑得起来。跑通之后再往里长复杂逻辑——路由表配置化、状态机、lint 校验,一步步加。结构本身就是给 AI 的护栏,骨架越薄,AI 帮你扩展时越不容易堆屎山。
只有 image-factory 一个东西注册成全局技能。用户说"做张封面""做组知识卡片""照这张海报做",都先进这个入口;入口读一张路由表,把请求分发到对应的业务薄壳。四个薄壳不单独注册,只能通过主入口内部调用。
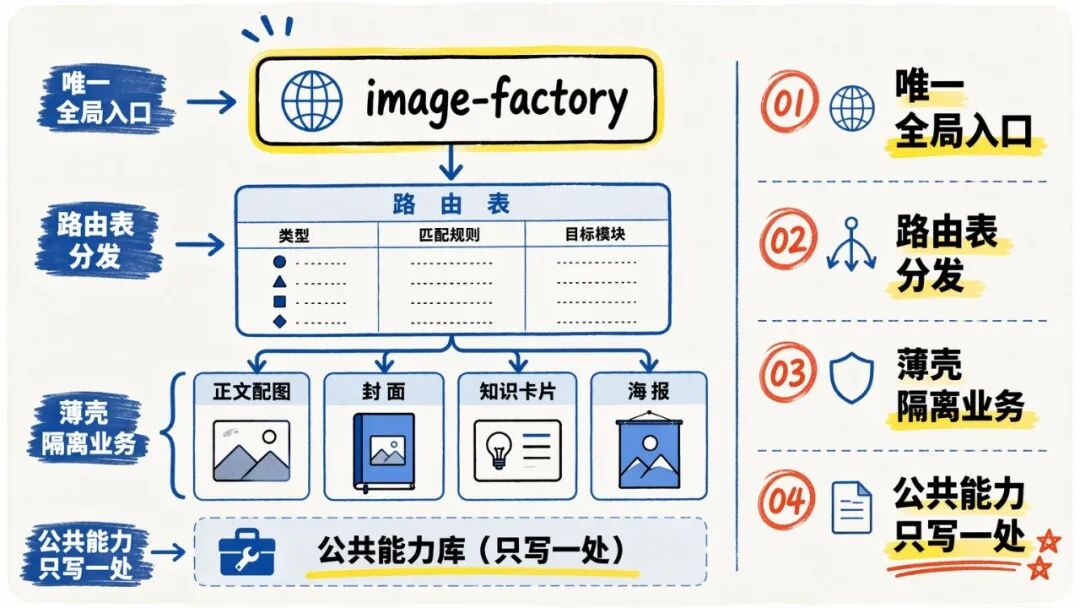
关键在于职责怎么切:
通用能力只写一处。 凭证边界、"默认 dry-run、加 --apply 才调付费 API"的门禁、产物分级、图片是否真实生成的校验、路径约定——这些所有业务都要遵守的规矩,只写在主入口。薄壳里明确标注一句"通用规范全部见主 skill,本文件不再重复"。
业务差异隔离在各自薄壳。 知识卡片薄壳只写卡片专属的 brief 字段、模板菜谱和后处理;海报薄壳只写海报那一套。它们互不 import、互不知道对方存在,改一个不会波及另一个。
加新东西是加文件,不是改核心。 想加一种新封面风格?在 cover-factory/templates/ 丢一个新的模板 JSON。想加一整条新业务线?加一个薄壳目录、在路由表里加一行。那个所有业务共用的生图引擎,一个字都不用动。
这套结构和代码工程里的"工厂化"是同一回事:公共逻辑下沉、业务实现隔离、用一张配置表把它们连起来。它比安装五个各自为政的独立 Skill 更好路由,也比一个几百行的巨型 SKILL.md 更稳、更好改。
更关键的是:当我让 AI 帮我扩展它时,AI 有明确的"该往哪放"的规则可循——新模板进 templates、新业务加薄壳、公共规则进主入口——而不是无脑往主文档里继续堆。架构本身,就是给 AI 的护栏。结构越清晰,AI 代写时越不容易堆出屎山。
05 哪些事情该交给脚本,哪些事情该交给 LLM
Skill 最容易出问题的地方,其实不是写得不够详细,而是业务流跑不稳——同样的输入,这次对了、下次错了,你永远不知道它会在哪一步飘。
根子上是一个认知错位:很多人把 Skill 当成"更长的提示词",以为把要求写得够细、约束够多,AI 就一定照做。但一个 Skill 里其实混着三类完全不同的活——有的该交给 LLM 判断,有的该交给脚本执行,有的该走 MCP 或外部工具调用。把它们全丢给 LLM 用自然语言"约束",就是不稳定的起点。
做过 Coze(或任何工作流平台)的人对这点会很有共鸣:一个纯 prompt 节点,你把提示词写到天上去,它也没法保证 100% 稳定输出;真正让流程稳下来的,是把确定性的步骤拆成独立的工作流节点——判断、取数、调 API、格式校验,各归各位。Skill 是同一个道理,只不过节点从可视化拖拽,换成了脚本、MCP 调用和 LLM 步骤的分工。
所以第一步不是"把提示词写得更狠",而是先分清:这一步到底该谁干。
判断标准很简单:只要答案应该稳定,就不要交给 LLM 猜。
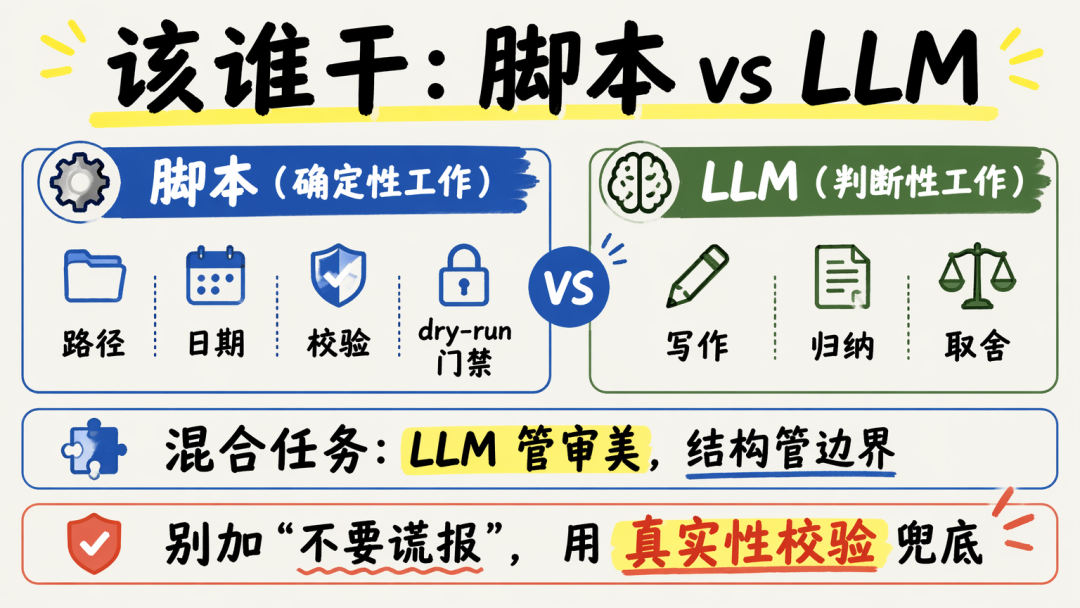
适合脚本的事情:
- 日期解析;
- 路径解析;
- 文件是否存在;
- JSON/YAML 校验;
- URL 抽取;
- 网页抓取;
- 状态推进;
- dry-run/apply;
- 字数统计;
- 图片文件是否真实生成;
- 重复项检测。
适合 LLM 的事情:
- 写作;
- 归纳;
- 风格改写;
- 信息分组;
- 判断一个案例对用户意味着什么;
- 给复杂材料起标题;
- 在多个合理方案里做取舍。
中间有一类混合任务:比如"给一篇长文配图"。画面画什么、贴合哪个段落、走什么调性,这是审美判断,交给 LLM;但用哪套模板、图片尺寸多少、调哪个 provider、是不是真的生成了 PNG、有没有误触发付费,这些必须由脚本和门禁保证。
也就是说,LLM 可以负责表达和审美,但确定性的边界要由结构化流程约束。
如果 AI 声称"图已生成",实际却没有文件落盘,不应该继续给 Skill 加一句"不要谎报已生成"。正确做法是:让脚本在生成后做真实性校验,没有 PNG 就明确报错,让付费只能由命令行显式 --apply 触发。
06 Skill 验收不能只看"跑通了"
一个 Skill 跑通一次,不代表它可用。
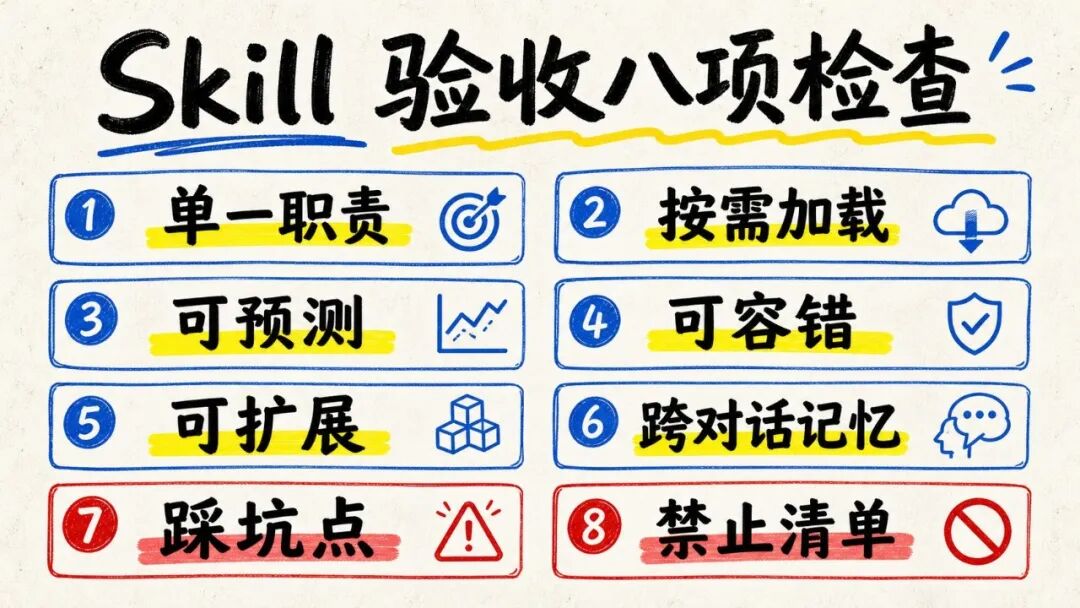
我现在更倾向用八项检查来验收:
第一,单一职责。 这个 Skill 到底只做一件事,还是偷偷做了三件事?如果一个 Skill 同时写稿、抓取、发布、同步,还没有状态机,那一定会变脆。
第二,按需加载。 name、description、正文和 references 是否分清楚?是不是把所有细节都塞进了 SKILL.md?
第三,可预测。 输入是什么,输出是什么,文件落在哪里,失败时停在哪里,有没有明确示例?
第四,可容错。 空输入、路径不存在、抓取失败、用户只说"OK"、外部服务超时,这些情况会发生什么?有没有人审断点?
第五,可扩展。 稳定流程和变化细节是否分开?新增一种模板、一个渠道、一个 provider,是改配置还是重写主 Skill?
第六,跨对话记忆。 状态是否落到文件里?还是全靠上一轮聊天记忆?只靠聊天记忆的流程,换个会话就断。
举个我自己 image-factory 的状态文件作参考——落 manifest.yaml,和 skill 同目录,每次调用读写:
# image-factory/manifest.yaml — 跨会话状态
current_task: article-illustration
stage: sample_generated          # planned → sampled → generated → inserted → uploaded
planned_slots: 5                 # plan 阶段计算出的插图数
generated_slots: 5
inserted_slots: 3                # 已完成插入
uploaded_slots: 0
last_run_at: 2026-07-02 22:15:30
source_article: "[[<文章路径>]]"
每个 skill 的字段设计不同,但关键是有 stage 字段跟状态机 next 状态对齐——换会话打开 skill,第一件事读 manifest.yaml,根据 stage 决定"接着做什么",不问用户"上次跑到哪了"。
第七,踩坑点。 有没有把最容易误解的边界写清楚?注意这里不是写事故长文,而是写对执行有帮助的短规则。
第八,禁止清单。 有没有明确"不做什么"?比如不默认发布、不默认写库、不代替用户审核、不凭标题补事实。
这八项的价值,是把"我感觉它可以"变成"它真的有可验证边界"。
07 个人用、团队用、商业用,要求完全不同
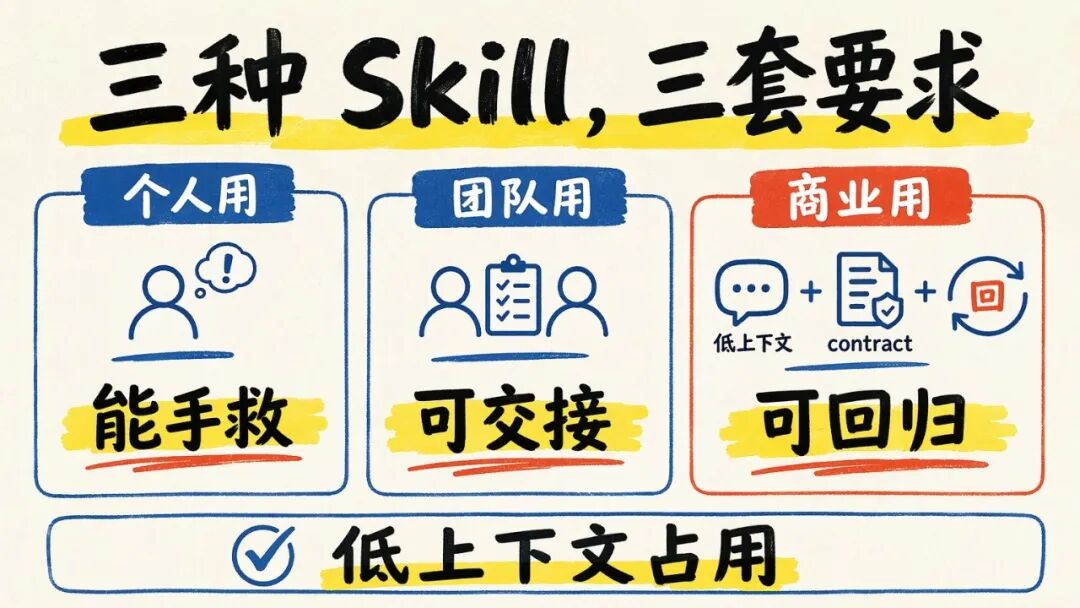
个人 Skill 可以粗糙一点。只要你自己知道怎么触发,失败了能手动救回来,哪怕写得口语化也能用。
团队 Skill 就不能这样。团队里有不同的人、不同 Agent、不同项目。Skill 必须让第一次接手的人也知道怎么跑,出错时知道停在哪里,改动时知道影响范围。
商业 Skill 和个人 / 团队 Skill 的分水岭,不在于"更严格",而在于要面对跨会话 / 跨 Agent / 跨用户三重不确定性,展开说两条:
① 低上下文占用 —— SKILL.md description 必须能被 Agent"扫一眼就懂"
商业场景下你的 Skill 会跟另外几十个 Skill 一起被 Agent 扫描。每个 Skill 的 description 决定 Agent 是否派你。如果你的 description 是长文,Agent 会在"没读完不敢选"这一层就把你跳过去了。
做法就是在 description 留三件事——「触发词 + 一句话干什么 + 边界」;背景、例子、原理全挪到正文和 references。不是"写得越详细越好",而是"Agent 一眼能不能判断这是不是它要找的"。
② regression case 落在仓库里 —— 不是"跑一遍就好"
个人 Skill 你自己跑一次通过就算能用。商业 Skill 不行——你今天改一个字段,下一版可能就把某个老用户的流程挂掉,而你不知道。
做法:仓库里建一个 tests/fixtures/ 存 3-5 个历史真实调用场景的输入 + 期望输出。改 Skill 前后各跑一次 python3 scripts/regression.py,输出差异 diff。人肉审:这是我改出来的、想要的差异,还是意外破坏了老行为?
这一条我踩过三次才加进来。前两次都是"看似小改,结果老用户跑不通",事后花几倍时间救。
其他几项,比如明确版本 / 稳定 contract / 自动化 lint / 安装边界 / 凭证边界 / 错误报告 / 用户审核节点——每一条都能单独展开,不赘述了。底层逻辑是同一个:凡是"跨用户跨会话时可能不一致"的地方,都要把不确定性变成结构。
这时 Skill 已经不是"提示词资产",而是产品的一部分。
08 最常见的坑
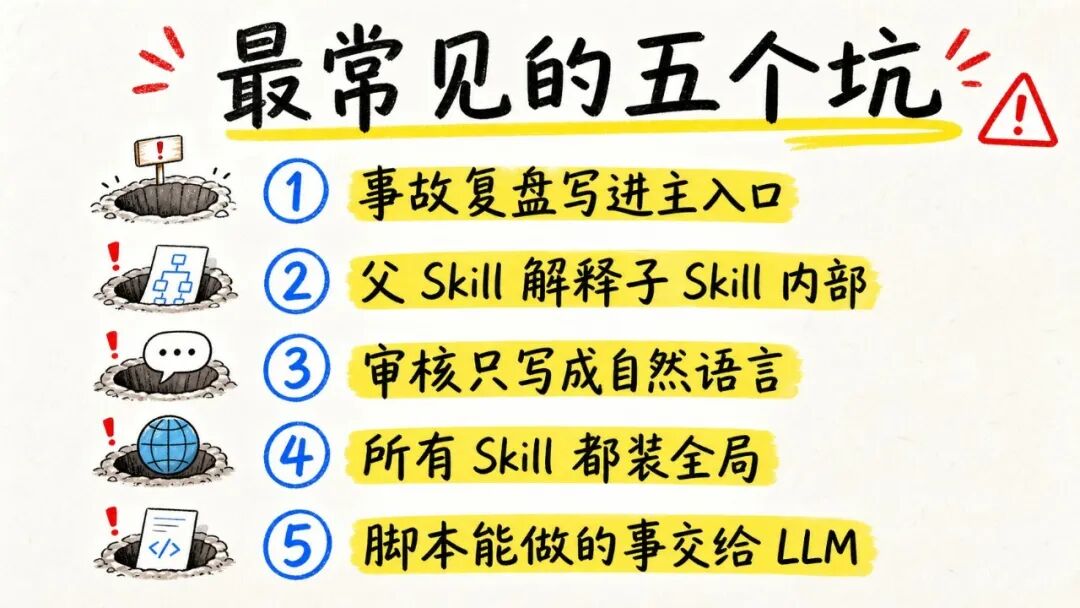
第一个坑,是把事故复盘写进主入口。 复盘应该进 ADR、handoff 或 postmortem,主 Skill 只保留执行需要知道的结论。
第二个坑,是父 Skill 解释子 Skill 的内部实现。 父 Skill 应该只说"下一步调用谁、输入输出是什么"。子 Skill 内部怎么做,由子 Skill 自己负责。
第三个坑,是把审核写成自然语言。 "用户确认后再执行"不够。真正可靠的是状态文件、--user-reviewed 参数或显式 approved flag。
第四个坑,是所有 Skill 都装全局。 Skill 不是越多越强。全局 Skill 太多,会增加路由成本,也会让 Agent 在相似描述之间犹豫。
第五个坑,是把脚本能做的事交给 LLM。 日期、路径、文件、状态、URL、超时,这些都应该工程化。LLM 的强项是理解和表达,不是当文件系统。
09 写在最后:门槛已经变了
Skill 好写,AI 十几秒就能给你一个。但"能跑一次"和"能一直稳、能一直改、能给别人用"之间,隔着的正是工程化这道坎。
逻辑其实很简单:简单 Skill 守住单一职责、别顺手扩展;复杂 Skill 别写成巨型文档、也别摊成一地独立 skill,而是一个入口、内部分层、公共能力只写一处;而贯穿始终的那条主线,是分清哪一步该交给 LLM、哪一步该交给脚本和 MCP,把不该猜的东西变成结构,而不是靠不断加提醒去硬扛。
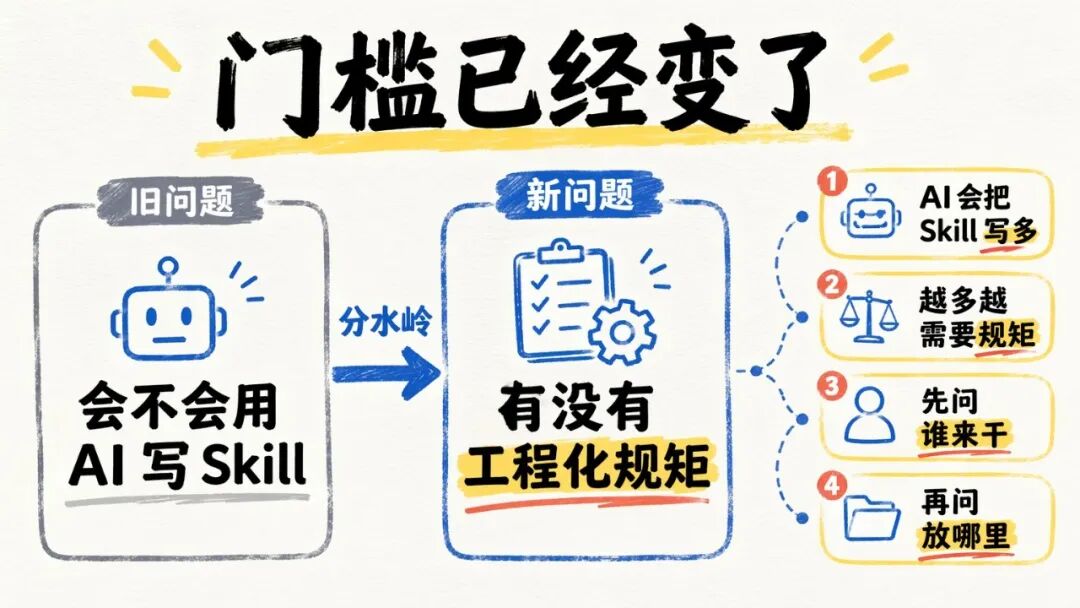
过去大家焦虑的是"我不会写 Skill",但这件事的门槛正在飞快归零——你不会写,AI 替你写。
于是分水岭悄悄换了位置:从"你会不会用 AI 写 Skill",变成了"当 AI 帮你把 Skill 越写越多、越改越复杂时,你有没有一套工程化的规矩,让它始终简洁、优雅、可维护"。
懂工程的人,Skill 会变成越用越顺的资产;不懂的人,迟早被自己那堆屎山反噬——就像不懂软件工程的人让 AI 狂写代码,最后代码没人敢碰。
所以从今天起,别再一失败就往主文档里堆提醒。每写一步,先停下来问两句:
- 这一步该谁干(LLM、脚本,还是 MCP)?
- 这块东西该放哪(主入口、薄壳,还是配置)?
把这两个问题问顺了,你的 Skill 就会从"越改越厚"变成"越改越薄"。